Вакансии для студентов и выпускников
Новое на сервере
RSS-лента "Новое на сервере"- 02.11.2026 Инструкция о порядке подготовки и передачи дел в архив
- 29.10.2026 Положение об официальном информационном веб-сервере ОГУ
- 27.10.2026 Журнал «Вестник ОГУ» № 3-2026
- 27.10.2026 Изменения № 1 в Положение об организации антивирусной защиты средств информатизации в ОГУ
- 26.10.2026 Изменения № 6 в Положение о стипендиальном обеспечении и других формах материальной поддержки обучающихся
- 21.10.2026 Журнал «Интеллект. Инновации. Инвестиции» № 5-2026
- 16.10.2026 Календарный план воспитательной работы на 2026/27 учебный год
- 15.10.2026 График работы спортивных секций
- 14.10.2026 Инструкция о порядке использования карты звуковых сигналов звонков громкого боя при преступлениях террористического характера и чрезвычайных ситуациях в ОГУ
Студенты программы ТОП ИТ разобрали реальный кейс создания ИИ-продукта
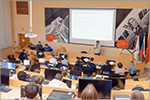
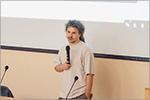
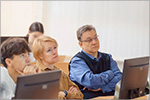
Для студентов первого курса прошел мастер‑класс «Как на самом деле делают ИИ‑продукты». Мероприятие было посвящено разбору кейса создания системы предиктивного обслуживания и автоматизации работы с нормативными документами. Спикером выступил представитель индустриального партнера, заместитель технического директора ООО «ВейвАксесс Сервис» Максим Шатов.
Студенты убедились, что создание ИИ-решений требует глубокого понимания не только самой технологии, но и процессов обработки данных, безопасности и экономики внедрения. На примере конкретного кейса участники разобрали, как из потока неструктурированных документов можно создать полезный инструмент, который помогает автоматизировать рутинные задачи и принимать решения быстрее. А вот успешное внедрение искусственного интеллекта — это не просто запуск готовой модели, а кропотливая инженерная работа. Обучающиеся увидели, как из хаотичного потока документов можно создать инструмент для автоматизации рутинных задач и повышения эффективности работы организации.
Максим Шатов наглядно продемонстрировал, почему модель составляет лишь 10% успеха, а остальные 90% зависят от правильной постановки задачи и инженерных решений. Он рассказал о том, что LLM-модели работают с токенами, а не со словами, поэтому даже небольшой документ может потребовать значительных вычислительных ресурсов. Участники узнали, как устроено «окно контекста», без которого модель просто перестает существовать, и какие проблемы возникают при работе с большими объемами информации.
Особое внимание было уделено практическим советам для разработчиков. Модель без контекста была образно названа «начитанным стажером»: она уверенно отвечает даже тогда, когда не знает ответа или галлюцинирует. Чтобы избежать таких ситуаций, необходимо тщательно проектировать архитектуру продукта, использовать методы RAG-конвейеров и правильно нарезать документы на фрагменты. Для стабильной работы готового сервиса важно измерять такие метрики, как точность ответов и обоснованность выводов, а не полагаться на единичные тесты.
Также студенты узнали об экономике локальных моделей. Оказалось, что GPU-ресурсы стоят дорого, и их утилизация становится ключевым фактором стоимости. Именно поэтому ночной прогон больших объемов данных стал стандартом индустрии: он позволяет снизить затраты и эффективно обрабатывать новые поступления.
Мастер-класс показал, что искусственный интеллект сегодня — это не просто модная технология, а мощный инженерный инструмент, требующий системного подхода и глубокого понимания процессов. Полученные знания помогут в разработке проектов как по кейсам от индустриальных партнеров программы ТОП ИТ, так и при создании собственных решений для бизнеса или науки. Это поможет сформировать востребованные профессиональные компетенции и подготовиться к работе над реальными проектами уже на этапе обучения.
Мастер-класс организован в рамках программы учебного центра «Академия информационных технологий» при поддержке Минцифры России и Аналитического центра при Правительстве Российской Федерации. Центр реализует программу подготовки топ-специалистов в сфере информационных технологий в рамках федерального проекта «Кадры для цифровой трансформации» национального проекта «Экономика данных и цифровая трансформация государства».
Фото Виталия Стратея
Ошибка в тексте? Выделите её и нажмите «Ctrl + Enter».
Для того, чтобы мы могли качественно предоставить вам услуги, мы используем cookies, которые сохраняются на вашем компьютере (сведения о местоположении; ip-адрес; тип, язык, версия ОС и браузера; тип устройства и разрешение его экрана; источник, откуда пришел на сайт пользователь; какие страницы открывает и на какие кнопки нажимает пользователь; эта же информация используется для обработки статистических данных использования сайта посредством аналитической системы «Спутник», интернет-сервиса Яндекс.Метрика и сервиса аналитики MyTracker). Нажимая кнопку «Согласен», вы подтверждаете то, что вы проинформированы об использовании cookies на нашем сайте. Отключить cookies вы можете в настройках своего браузера.




Сегодня
6 ноября 2026 г., пятница
10 неделя
(нижняя)
Скоро
- 16.12.2026 Заседания диссертационного совета 24.2.352.05
- 29.01.2027 Заседание диссертационного совета 24.2.352.05
- 04.02.2027 Заседание диссертационного совета 24.2.352.01

Приглашаем принять участие
- Университетские субботы для школьников
- Дни открытых дверей в ОГУ
- Школа юного биохимика и микробиолога
- X Международная студенческая олимпиада по менеджменту
- Международная научная конференция «Химическая физика молекул и полифункциональных материалов» (Chemical physics of molecules and polyfunctional materials)
- Школа-семинар молодых ученых и специалистов в области компьютерной интеграции производства
- VI Всероссийская научно-практическая конференция «Теория и практика инновационных исследований в области естественных наук»
- Всероссийская научно-практическая конференция «Рычковская осень»
- Международная научно-практическая конференция «Обеспечение и проблемы реализации конституционных прав и свобод в новых геополитических условиях»
- VIII Всероссийская научно-практическая конференция «Региональные проблемы геологии, географии, техносферной и экологической безопасности»
- Всероссийская научно-практическая конференция «Интердисциплинарные исследования переводческой деятельности»
- XXI Международная научно-практическая конференция «Прогрессивные технологии в транспортных системах»
Объявления
-
06.11.2026 Соцопрос об осведомленности о проектах «Передовые инженерные школы» и ПСАЛ «Приоритет-2030»
Уважаемые преподаватели и студенты, примите участие в социологическом опросе об осведомленности о проектах «Передовые инженерные школы» и ПСАЛ «Приоритет-2030». Опрос проводится с 2 по 16 ноября 2026 г.
-
06.11.2026 Программа повышения квалификации «Профилактика и предупреждение коррупции в образовательных организациях»
С 10 ноября в центре дополнительного профессионального образования реализуется программа повышения квалификации «Профилактика и предупреждение коррупции в образовательных организациях».
-
03.11.2026 Проект «Старт в будущее» ООО «ЛУКОЙЛ-Уралнефтепродукт» для студентов и выпускников ОГУ
ООО «ЛУКОЙЛ-Уралнефтепродукт» реализует проект «Старт в будущее». Участниками проекта «Старт в будущее» могут стать выпускники и студенты выпускных курсов Оренбургского государственного университета bvtyb В.А. Бондаренко технических и экономических направлений подготовки, которым предоставляется возможность трудоустройства и системного сопровождения карьерного развития. Цель программы — выявить молодых управленцев и подготовить их к работе на ключевых позициях в компании. ›››
-
27.10.2026 Программа «Ямбургская смена. Стажировка»
ООО «Газпром добыча Ямбург» приглашает студентов Оренбургского государственного университета пройти программу «Ямбургская смена. Стажировка» на производственных объектах и получить опыт работы в реальных условиях. ›››
-
23.10.2026 Выборы на должности заведующих кафедрами
ОГУ объявляет выборы на должности заведующих кафедрами: ›››
-
22.10.2026 Межрегиональная олимпиада школьников им. И.Я. Верченко стартует 1 ноября
Межрегиональная олимпиада школьников имени И.Я. Верченко по математике и криптографии проводится ежегодно с 1991/92 учебного года. Координацию проведения олимпиады осуществляет Институт криптографии, связи и информатики Академии ФСБ России. ›››
-
20.10.2026 Проект «Оценка и развитие управленческих компетенций в российских образовательных организациях» для студентов 1 курса ОГУ
Департамент государственной молодежной политики и воспитательной деятельности Минобрнауки России совместно с АНО «Россия — страна возможностей» приглашает принять участие в проекте «Оценка и развитие управленческих компетенций в российских образовательных организациях» и пройти диагностику универсальных компетенций обучающихся первого курса бакалавриата, специалитета и магистратуры. ›››
-
14.10.2026 Конкурс на должности ППС
ОГУ объявляет конкурс на должности профессорско-преподавательского состава по кафедрам: ›››
-
09.10.2026 «Историческая правда» — просвещение теперь в вашем смартфоне
«Историческая правда» — историко-просветительский медиаресурс для студентов, преподавателей и всех, кому важно понимать прошлое России через факты, источники и современную гуманитарную повестку. ›››
-
01.10.2026 Набор в военный учебный центр при ОГУ на обучение на военно-учетные специальности
Военный учебный центр имени Героя Советского Союза генерал-полковника Родимцева А.И. при ОГУ с 1 октября 2026 года объявил очередной набор на военно-учетные специальности по программам подготовки солдат запаса: ›››
-
10.08.2026 Программы переподготовки и повышения квалификации бухгалтеров и аудиторов
Учебно-методический центр по подготовке профессиональных бухгалтеров и аудиторов ОГУ объявляет запись на программы дополнительного профессионального образования 2026/27 учебного года. ›››
460018, г. Оренбург,
просп. Победы, д. 13
- по обеспечению правовой и социальной защиты обучающихся: 8 800 222-55-71 (доб. 1)
- по психологической помощи студенческой молодежи: 8 800 222-55-71 (доб. 2)


Официальный сайт федерального государственного бюджетного образовательного учреждения высшего образования «Оренбургский государственный университет имени В.А. Бондаренко».
Соглашение об использовании сайтаПолитика обработки персональных данных веб-сайтов ОГУ
© ОГУ, 1999–2026. При использовании материалов сайта гиперссылка обязательна!